Contexte
Les données satellitaires Sentinel-2 fournissent une observation multispectrale régulière de la surface terrestre à différentes résolutions spatiales. Ces données peuvent notamment être utilisées pour caractériser la végétation, les surfaces agricoles, les zones artificialisées ou encore les surfaces aquatiques.
Parallèlement, l'ESA WorldCover fournit une cartographie globale de l'occupation du sol à partir de données satellitaires et constitue ici une source de labels permettant d'entraîner un modèle d'apprentissage supervisé.
Ce projet explore donc la possibilité d'apprendre la relation entre les signatures spectrales observées par Sentinel-2 et les classes d'occupation du sol proposées par WorldCover.
« Dans quelle mesure les données Sentinel-2 permettent-elles de discriminer les principales classes d'occupation du sol, et quels choix de features et de modèles permettent d'obtenir la meilleure généralisation spatiale ? »
Présentation des données
| Donnée | Source | Rôle | Résolution |
|---|---|---|---|
| Sentinel-2 L2A | Copernicus | Prédicteurs | 10 / 20 / 60 m |
| ESA World Cover 2021 | ESA | Labels | 10 m |
| Zone d’étude | Sud-Ouest de la France / Occitanie | Domaine expérimental | - |
Sur la tuile utilisée dans cette étude, les données ESA World Cover présentent les classes suivantes :
Classes ESA World Cover
| Code classe | Nom |
|---|---|
| 10 | Tree Cover |
| 30 | Grassland |
| 40 | Cropland |
| 50 | Built-up |
| 60 | Bare/Sparse vegetation |
| 80 | Permanent water |
| 90 | Herbaceous wetland |
Etape 1 : Pre-processing des données
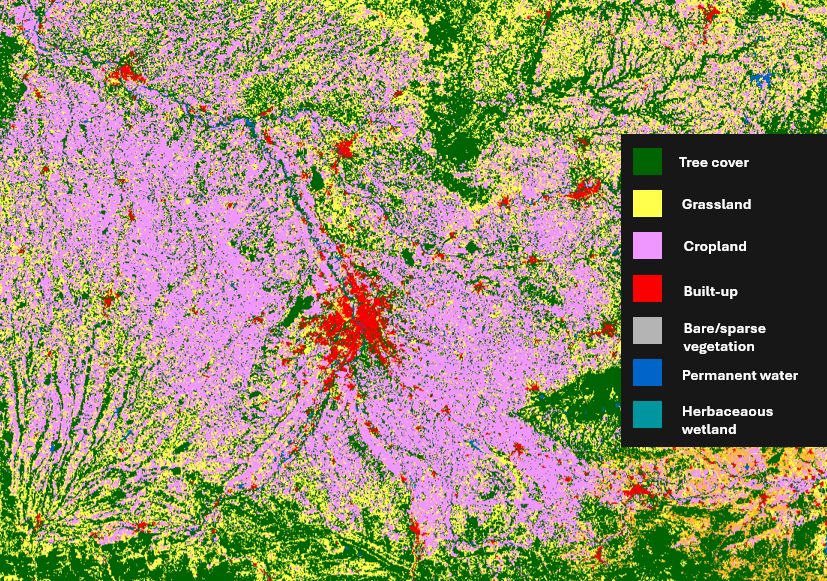
Les données Land Cover qui serviront de référence (labels) pour cette étude sont récupérées sur le site de l’ESA : viewer.esa-worldcover.org. La tuile correspondant à la région de Toulouse (France, Occitanie) est téléchargée depuis le portail. Ce produit fait référence pour l’année 2021.
Pour les données d’entraînement, on se tourne vers le portail Copernicus qui permet de télécharger les données Sentinel-2 L2A pour une zone et temps donnés. Par souci de cohérence avec les données ESA World Cover, on récupère une date en 2021, tout en cherchant à optimiser la couverture nuageuse. C’est la date du 15 avril 2021 qui présente la meilleure pertinence, avec un Cloud Cover très faible (2.8).
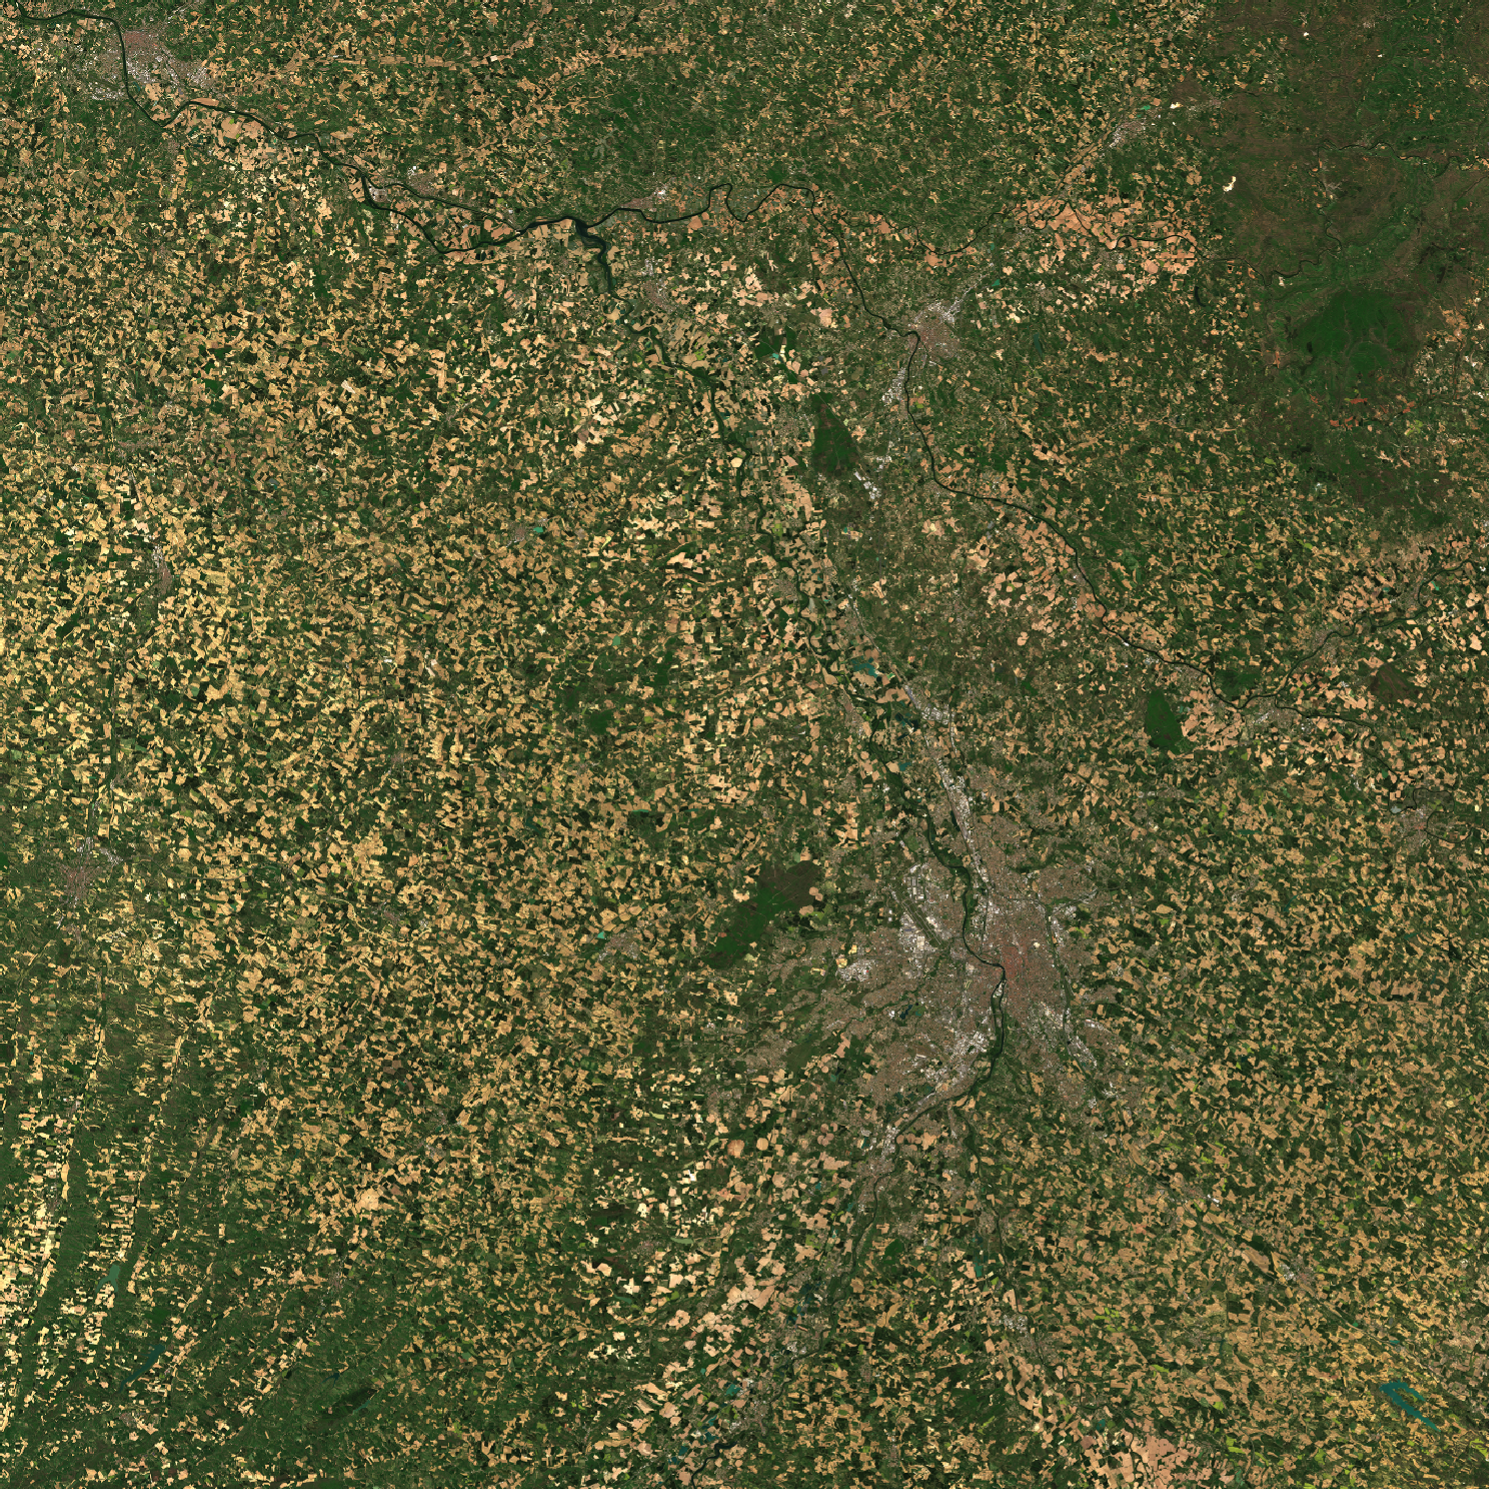
Les données Sentinel-2 L2A comprennent l’ensemble des bandes de 01 à 12 (ainsi que AOT, SCL, TCI, WVP) à des résolutions spatiales allant de 10m, 20m ou 60m selon les bandes considérées. Les données à 10m étant limitées à quelques bandes et les données ESA World Cover se trouvant à une résolution spatiale de 10m, le choix est fait de travailler à 20m, en appliquant un rééchantillonnage sur les données ESA pour les aligner parfaitement sur la grille Sentinel-2.
Ce rééchantillonnage est réalisé en parcourant le raster en fenêtre (grille) de 4 pixels (20m de résolution spatiale) et en sélectionnant la valeur majoritaire. Un score de purity est calculé simultanément afin d’identifier les pixels ambigus (pas de classe majoritaire) et de les écarter ensuite lors de l’entraînement des modèles.
A l’issue de cette étape, un raster de labels ESA World Cover à 20m de résolution est généré et les rasters Sentinel-2 L2A sont prêts pour commencer l’approche machine learning.
Etape 2 : Sélection des Area of Interest (AOI)
La tuile World Cover entière ne peut être utilisée comme base pour l’entraînement des modèles, d’une part à cause du trop grand nombre de pixels qui alourdiraient les temps de calcul au-delà du raisonnable, d’autres part en raison de la forcément très inégale répartition des pixels qui pourrait générer des biais d’entraînement.
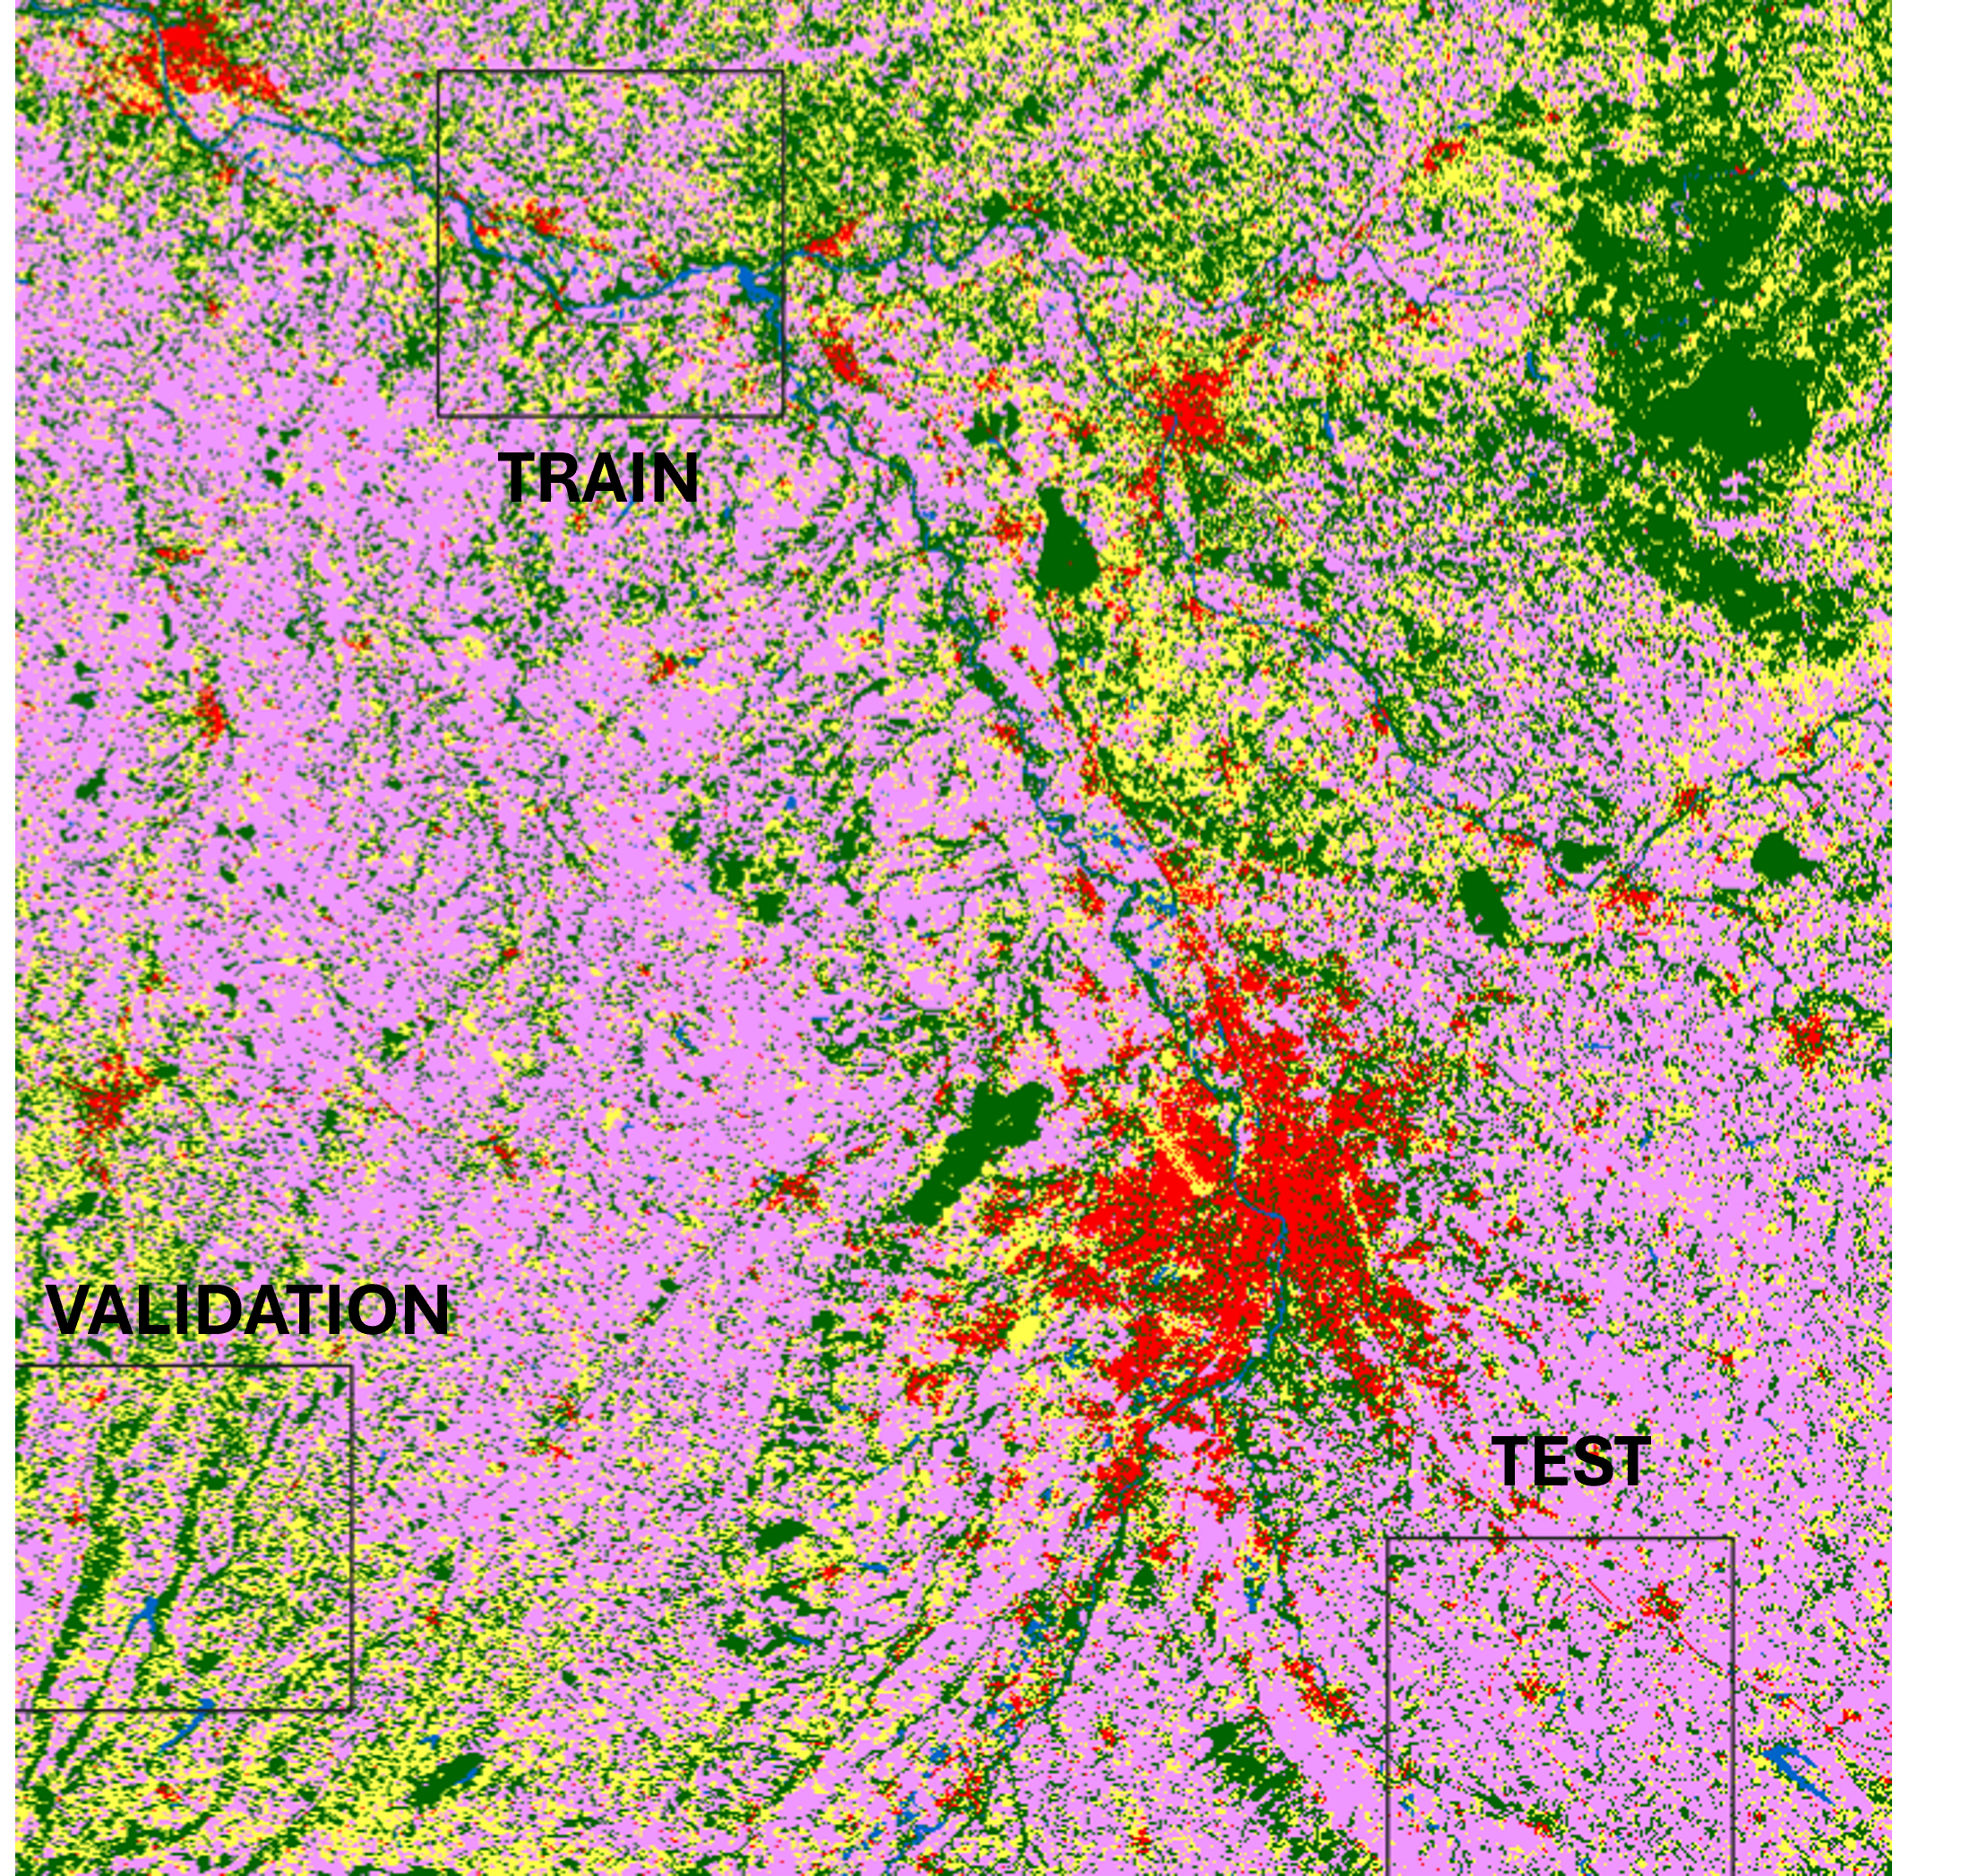
Le choix est donc fait de travailler sur des zones de 20x20km (soit 1 000 000 de pixels), ce qui représente une taille à la fois exploitable et suffisamment riche en information. Néanmoins, là où une approche standard en machine learning consiste à appliquer une séparation randomisée des données en un jeu d’entraînement, un jeu de validation et un jeu de test, la problématique est légèrement différente dans le domaine de l’apprentissage géospatial. En effet, les risques de biais liés à l'autocorrélation spatiale des données nécessitent une totale indépendance géographique entre les données d’entraînement, de validation et de test.
On cherche donc à identifier un triplet d’AOI (train, validation, test) en optimisant leurs caractéristiques. A l’œil, les zones autour des communes petites à moyennes semblent présenter une bonne diversité de classes, mais on laisse le soin à un script Python de confirmer et sélectionner les meilleures zones. Pour cela, on parcourt le raster en grille avec calcul de plusieurs paramètres : Entropie de Shannon, Pixels valides (purity > 0.75), nombre de classes et équilibre. Une distance minimale de 20km est imposée entre chaque zone pour garantir l'indépendance spatiale.
A l’issue de cette étape, le meilleur triplet est déterminé ainsi :
- TRAIN Zone d’entraînement (20x20km) autour des communes de Valence, Golfech, Saint-Nicolas-de-la-Grave
- VAL Zone de validation (20x20km) dans le Sud-Ouest de Toulouse, aux alentours des communes de Masseube / Bellegarde
- TEST Zone de test (20x20km) aux alentours des communes de Nailloux / Villefranche-de-Lauragais
Un script Python est ensuite appliqué pour extraire les données ESA ainsi que Sentinel-2 pour ces 3 zones, au format .parquet bien adapté au traitement de ce volume de données.
Etape 3 : Tests exploratoires
L’état de l’art et les connaissances métier dans le domaine de la télédétection / Machine Learning géospatial nous poussent à sélectionner 9 bandes de Sentinel-2 pour une première approche exploratoire :
| Bande | Domaine spectral | Résolution | Intérêt potentiel |
|---|---|---|---|
| B02 | Bleu | 10 m | eau, végétation, sols |
| B03 | Vert | 10 m | végétation, eau |
| B04 | Rouge | 10 m | végétation, sols |
| B05 | Red Edge | 20 m | état de la végétation |
| B06 | Red Edge | 20 m | végétation |
| B07 | Red Edge | 20 m | végétation |
| B8A | NIR | 20 m | végétation, humidité |
| B11 | SWIR | 20 m | humidité, sols, bâti |
| B12 | SWIR | 20 m | sols, végétation, bâti |
Un script python est utilisé pour lire les .parquet générés précédemment. On y filtre les pixels sur un critère de Purity > 0.75 (ce qui élimine environ 10% des pixels) et on sélectionne un seuil maximal de 10 000 critères par classe. On configure ensuite un ensemble de 3 modèles (Scikit-Learn) :
- • DummyClassifier : modèle basique voué à servir de témoin
- • DecisionTree : modèle en arbre unique pour benchmarking
- • RandomForest : modèle de référence dont on va évaluer la performance par rapport aux autres
# Configuration et entrainement des modeles baselines (Dummy, DecisionTree, RandomForest)
Les critères retenus pour l’évaluation sont l’accuracy, la balanced accuracy et surtout le F1-score (moyenne des scores F1 de chaque classe) qui permet de prendre en compte la précision et le recall et s’avère plus adapté aux problèmes présentant des classes déséquilibrées.
A l’issue de ce test avec un paramétrage standard des modèles, les résultats obtenus sur l’ensemble de validation sont les suivants :
| Model | Macro F1-Score | Accuracy | Balanced Accuracy |
|---|---|---|---|
| Dummy Classifier | 0.068 | 0.312 | 0.143 |
| Decision Tree | 0.464 | 0.723 | 0.601 |
| Random Forest | 0.496 | 0.761 | 0.592 |
Le DummyClassifier fournit une référence volontairement naïve, avec un macro-F1 de seulement 0,068. Les modèles basés sur des arbres améliorent très nettement ce résultat : le Random Forest atteint un macro-F1 de 0,496.
Cette première expérience constitue donc un premier élément en faveur de l'hypothèse de départ : les bandes spectrales Sentinel-2 contiennent suffisamment d'information pour apprendre une discrimination non triviale entre les classes étudiées.
Etape 4 : Feature Engineering et Ablation Study
L’étape suivante consiste à optimiser les résultats obtenus en influant sur les features d’entrée (prédicteurs). On calcule un ensemble d’indices spectraux classiques de télédétection, que l’on ajoute à notre feature set de prédicteurs :
| Indice / ratio | Formule | Interprétation |
|---|---|---|
| NDVI | (B8A−B04)/(B8A+B04) | Vigueur / présence de végétation |
| NDWI | (B03−B8A)/(B03+B8A) | Information liée à l'eau |
| NDMI | (B8A−B11)/(B8A+B11) | Humidité de la végétation |
| NDBI | (B11−B8A)/(B11+B8A) | Information liée aux surfaces bâties |
| RE1 | B05/B04 | Détection précoce du stress végétal et teneur initiale en chlorophylle |
| RE2 | B06/B04 | Teneur globale en chlorophylle a+b et estimation du LAI (indice foliaire) |
| RE3 | B07/B04 | Biomasse dense et niveau de maturité/sénescence de la canopée |
| NIR_RE1 | B8A/B05 | Évaluation de la structure foliaire et de la densité de canopée sans saturation |
| NIR_RE2 | B8A/B06 | Ratio du plateau PIR/RE intermédiaire, sensible aux variations d'azote et de biomasse active |
| NIR_RE3 | B8A/B07 | Ratio du plateau PIR/RE haut, indicateur de l'efficacité photosynthétique globale |
Ces nouvelles features sont ensuite évaluées en entraînant les modèles précédents sur un grand ensemble de FeatureSets :
- 9 Bands : Les 9 bandes utilisées à l’origine
- 9 Bands + Indices : Les 9 bandes pour les indices NDVI, NDWI, NDMI, NDBI
- 9 Bands + Indices + Ratios : La totalité des 9 bandes, indices et ratios
- 9 Bands + NDVI seul
- 9 Bands + NDWI seul
- 9 Bands + NDMI seul
- 9 Bands + NDBI seul
Par définition, les indices type NDVI sont basés sur des informations déjà contenues dans les bandes Sentinel-2. Le fait de les tester ensemble et séparément sert à vérifier s’ils apportent tout de même une information discriminante par rapport aux bandes et si oui, quels indices sont les plus pertinents.
Résultats de l'Ablation Study (Performances par Feature Set)
Validation Set| Feature Set | Modèle | Accuracy | Balanced Acc. | Macro F1-Score |
|---|---|---|---|---|
| RGB_NIR | Decision Tree | 0.723 | 0.601 | 0.464 |
| Random Forest | 0.761 | 0.592 | 0.496 | |
| 9_bands | Decision Tree | 0.753 | 0.621 | 0.491 |
| Random Forest | 0.804 | 0.627 | 0.515 | |
| 9_bands_NDWI | Decision Tree | 0.757 | 0.624 | 0.494 |
| Random Forest | 0.802 | 0.626 | 0.513 | |
| 9_bands_NDVI | Decision Tree | 0.755 | 0.604 | 0.486 |
| Random Forest | 0.802 | 0.620 | 0.510 | |
| 9_bands_indices_ratios | Decision Tree | 0.762 | 0.633 | 0.493 |
| Random Forest | 0.795 | 0.628 | 0.512 | |
| 9_bands_indices | Decision Tree | 0.751 | 0.623 | 0.485 |
| Random Forest | 0.794 | 0.615 | 0.501 | |
| indices_ratios_only | Decision Tree | 0.710 | 0.603 | 0.444 |
| Random Forest | 0.749 | 0.594 | 0.479 |
Le modèle témoin DummyClassifier donne sur l'ensemble des configurations un score invariant : Accuracy = 0.312, Balanced Acc. = 0.143, Macro F1 = 0.068.
L’ajout des indices spectraux semble au final apporter peu d’amélioration mesurable par rapport aux seules 9 bandes dans le cadre de notre Random Forest, ce qui s’explique sans doute par le fait que le modèle est capable de retirer l’essentiel de l’information contenue dans ces indices depuis les bandes brutes. Pour la suite de l’exploration, on retient néanmoins 3 feature sets :
- •9 bands : Le meilleur compromis a priori entre performance et simplicité du modèle
- •9 bands + NDVI + NDWI : Ces deux indices semblent être ceux dont l’ajout modifie le plus favorablement les performances.
- •9 bands + indices + ratios : Le plus complet (potentiel supérieur pour des modèles type Gradient Boosting).
On cherche ensuite à intégrer la dimension spatiale du problème. Pour intégrer cette information, des statistiques locales sont calculées sur des fenêtres carrées centrées sur chaque pixel :
Deux tailles de voisinage sont testées : 3×3 pixels (60 m × 60 m) et 5×5 pixels (100 m × 100 m), calculées sur B04, B8A et B11.
Impact du Contexte Spatial sur les Performances
Ablation Study Spatiale| Feature Set | Modèle | Accuracy | Balanced Acc. | Macro F1-Score |
|---|---|---|---|---|
| 9_bands (Baseline) | Decision Tree | 0.753 | 0.621 | 0.491 |
| Random Forest | 0.804 | 0.627 | 0.515 | |
| 9_bands_spatial_3 | Decision Tree | 0.744 | 0.634 | 0.491 |
| Random Forest | 0.809 | 0.630 | 0.524 | |
| 9_bands_spatial_5 | Decision Tree | 0.755 | 0.638 | 0.499 |
| Random Forest | 0.810 | 0.632 | 0.534 | |
| 9_bands_NDVI_NDWI_spatial_3 | Decision Tree | 0.761 | 0.642 | 0.501 |
| Random Forest | 0.810 | 0.633 | 0.529 | |
| 9_bands_NDVI_NDWI_spatial_5 | Decision Tree | 0.757 | 0.633 | 0.503 |
| Random Forest | 0.811 | 0.638 | 0.542 | |
| 9_bands_indices_ratios_spatial_3 | Decision Tree | 0.770 | 0.648 | 0.501 |
| Random Forest | 0.816 | 0.636 | 0.530 | |
| 9_bands_indices_ratios_spatial_5 | Decision Tree | 0.776 | 0.650 | 0.506 |
| Random Forest | 0.818 | 0.635 | 0.532 | |
| 9_bands_mean5 | Decision Tree | 0.749 | 0.630 | 0.496 |
| Random Forest | 0.807 | 0.637 | 0.540 | |
| 9_bands_std5 | Decision Tree | 0.750 | 0.642 | 0.491 |
| Random Forest | 0.808 | 0.635 | 0.531 |
- Gain systématique de la dimension spatiale : L'ajout d'un contexte spatial ($3\times3$ ou $5\times5$) augmente significativement le Macro F1 (de 0.515 à >0.530) et l'Accuracy globale.
- Fenêtres $5\times5$ vs $3\times3$ : La fenêtre contextuelle élargie ($5\times5$) surpasse systématiquement la fenêtre $3\times3$, permettant de mieux lisser le bruit d'enregistrement spectral.
- Efficacité de la moyenne spatiale : L'agrégation spectrale simple 9_bands_mean5 atteint un excellent Macro F1 = 0.540, très proche de 9_bands_NDVI_NDWI_spatial_5 (0.542).
L'ajout de statistiques spatiales produit une amélioration plus nette que celle observée avec les indices spectraux. Les datasets retenus pour la suite sont :
- 9 Bands + mean 5x5 : Meilleur compromis performance/simplicité à priori
- 9 Bands + mean + std 5x5 : Potentiel apport d’information supplémentaire
- 9 Bands + indices + ratios + mean + std 5x5 : Le plus complet
Cette étape nous aura permis d’évaluer la pertinence et le poids des principaux prédicteurs utilisables et dérivables à partir des données Sentinel-2. Le travail de comparaison et d’ablation permet d’éliminer certains indices potentiellement redondants et de déterminer 3 ensembles de features de référence à tester avec différents modèles de classification.
Etape 5 : Comparaison avec des modèles de Gradient Boosting
Il est maintenant temps de procéder à la comparaison de performance entre différents modèles. Si Random Forest est une référence reconnue dans la littérature, d’autres modèles de Classifier – souvent plus récents – peuvent constituer des alternatives de choix. Au regard de l’état de l’art sur le sujet, 3 modèles de Gradient Boosting apparaissent comme des candidats sérieux : XGB Classifier, Light GBM et le GradientBoosting Classifier de scikit-learn
| Modèle | Famille | Principe | Rôle dans l’étude |
|---|---|---|---|
| RandomForest | Bagging d’arbre | Agrégation de nombreux arbres | Référence robuste |
| SkLearn Gradient Boosting | Gradient Boosting | Arbres construits séquentiellement | Benchmark |
| Light GBM (LGBM) | Gradient Boosting | Boosting optimisé et régularisé | Performance / vitesse |
| XGB Classifier | Gradient Boosting | Boosting basé sur histogrammes | Performance / vitesse |
Les modèles sont tout d’abord entraînés avec des paramètres standards et leurs résultats sont évalués selon leur score macro-F1, leur accuracy, balanced accuracy mais aussi temps de traitement.
En sortie, nous obtenons :
| Modèle | Feature set | Accuracy | Balanced Acc. | Macro-F1 | Temps |
|---|---|---|---|---|---|
| Random Forest | Mean 5×5 | 0,807 | 0,634 | 0,536 | 5,9 s |
| Gradient Boosting | Mean 5×5 | 0,821 | 0,661 | 0,550 | 323,8 s |
| XGBoost | Spatial 5×5 | 0,831 | 0,648 | 0,567 | 6,4 s |
| LightGBM | Full | 0,842 | 0,661 | 0,572 | 7,6 s |
Deux configurations apparaissent comme les meilleures candidates pour la phase d'optimisation : LightGBM avec l'ensemble complet de variables, et XGBoost avec les variables spectrales et spatiales. GradientBoosting ScikitLearn offre aussi une performance solide à priori, mais son temps d’entraînement très largement supérieur pour des résultats légèrement en deça en font un moins bon candidat pour un tuning fin.
Etape 6 : Tuning des modèles finalistes
Les deux modèles sélectionnés font ensuite l’objet d’une recherche des paramètres optimaux via RandomizedSearchCV.
Dans ce cadre, une cross-validation stratifiée en 3 folds est utilisée sur le jeu d’entraînement, avec le macro F-1 comme métrique à optimiser pour accorder un poids similaire à chacune des classes. Cette approche nécessaire à la recherche des meilleurs hyperparamètres reste cependant potentiellement sensible à l’autocorrélation spatiale et ne remplace pas la validation spatialement indépendante mise en place précédemment.
| Modèle | Macro-F1 CV | Macro-F1 validation spatiale |
|---|---|---|
| LightGBM baseline | — | 0,572 |
| LightGBM tuned | 0,793 | 0,564 |
| XGBoost tuned | 0,777 | 0,570 |
Ainsi le tableau ci-dessus démontre que les performances très élevées obtenues en cross-validation 3 folds ne sont pas reproduits sur le dataset de validation, ce qui confirme en outre l’importance de conserver un jeu de validation géographiquement indépendant.
Etape 7 : Analyse des erreurs
Après le tuning, les modèles LightGBM et XGBoost sont évalués sur le jeu de validation spatialement indépendant. L’analyse ne se limite pas à l’accuracy globale : les métriques sont étudiées classe par classe afin de mettre en évidence les erreurs de classification et l’impact du déséquilibre entre les classes.
| Classe | Support | LGBM Précision |
LGBM Rappel |
LGBM F1 |
XGB Précision |
XGB Rappel |
XGB F1 |
|---|---|---|---|---|---|---|---|
| Tree cover | 278 176 | 0,892 | 0,834 | 0,862 | 0,896 | 0,834 | 0,864 |
| Grassland | 260 049 | 0,733 | 0,868 | 0,795 | 0,736 | 0,871 | 0,798 |
| Cropland | 343 852 | 0,938 | 0,828 | 0,880 | 0,938 | 0,833 | 0,882 |
| Built-up | 4 127 | 0,284 | 0,938 | 0,435 | 0,286 | 0,938 | 0,438 |
| Bare / sparse vegetation | 24 | 0,000 | 0,000 | 0,000 | 0,000 | 0,000 | 0,000 |
| Permanent water | 6 279 | 0,850 | 0,931 | 0,889 | 0,856 | 0,947 | 0,900 |
| Herbaceous wetland | 80 | 0,052 | 0,237 | 0,085 | 0,068 | 0,225 | 0,105 |
Les deux modèles présentent des performances très proches sur les principales classes. Le Tree cover, le Grassland et le Cropland obtiennent des F1 compris entre 0,79 et 0,88, tandis que la classe Permanent water est également bien reconnue.
Une difficulté importante apparaît cependant pour la classe Built-up. Son rappel élevé (~0,94) indique que la majorité des pixels bâtis sont correctement détectés, mais sa précision très faible (~0,28) montre que de nombreux pixels appartenant à d'autres classes sont également prédits comme bâtis. Le modèle a donc tendance à sur-prédire cette classe.
Les classes Bare / sparse vegetation et Herbaceous wetland restent particulièrement difficiles à modéliser. Cette observation doit toutefois être interprétée avec prudence : elles disposent respectivement de seulement 24 et 80 observations dans le jeu de validation. Les métriques associées sont donc beaucoup moins stables que celles des classes majoritaires.
Les matrices de confusion permettent de préciser la nature de ces erreurs. Les principales confusions concernent les classes Tree cover, Grassland et Cropland. Ces classes correspondent toutes à des couvertures végétales dont les signatures spectrales peuvent être proches, notamment lorsqu'elles sont observées à une résolution de 20 m.
La classe Herbaceous wetland est également difficile à distinguer, notamment vis-à-vis des surfaces en eau. Cette difficulté peut s'expliquer par la proximité spectrale entre certaines zones humides et les pixels contenant de l'eau ou de la végétation humide.
Comparaison des modèles
| Modèle | Accuracy | Balanced Accuracy | Macro-F1 |
|---|---|---|---|
| LightGBM tuned | 0,8427 | 0,6625 | 0,5637 |
| XGBoost tuned | 0,8454 | 0,6640 | 0,5695 |
Les différences entre les deux modèles restent faibles. XGBoost obtient une légère avance sur l'accuracy et le macro-F1, tandis que les deux modèles présentent une balanced accuracy très proche. Aucun modèle ne se distingue donc nettement sur l'ensemble des critères.
À retenir : l'erreur de classification provient principalement de la confusion entre les différentes classes de végétation, tandis que les classes disposant de signatures spectrales plus distinctes, comme l'eau, sont mieux reconnues. Les très faibles performances observées sur certaines classes rares doivent être interprétées avec prudence en raison de leur faible nombre d'observations dans le jeu de validation.
Etape 8 : Généralisation sur la zone de test
Nous procédons maintenant à l’application des modèles LGBM et XGBoost sur la zone de test, qui contient uniquement des pixels totalement indépendants de tout entraînement et validation réalisé jusqu’à maintenant. Les zones de train et validations sont fusionnées en un seul dataset qui va servir à entraîner les modèles avec les paramètres optimaux déterminés lors des étapes précédentes.
Performances finales sur la zone de test
Une fois le tuning terminé, les ensembles d'entraînement et de validation sont fusionnés afin d'entraîner les deux modèles finalistes avec leurs hyperparamètres optimisés. Les modèles sont ensuite appliqués une seule fois sur la zone de test, totalement indépendante des données utilisées précédemment.
Les résultats obtenus permettent ainsi d'évaluer la capacité de généralisation des modèles sur une zone géographique jamais utilisée lors de l'entraînement ou de la sélection des hyperparamètres.
| Modèle | Accuracy | Balanced Accuracy | Macro-F1 |
|---|---|---|---|
| LightGBM | 0,8682 | 0,6954 | 0,6065 |
| XGBoost | 0,8718 | 0,6874 | 0,6002 |
Les deux modèles obtiennent des performances globales proches. XGBoost atteint la meilleure accuracy avec 87,18 %, tandis que LightGBM obtient la meilleure balanced accuracy (69,54 %) et le meilleur Macro-F1 (0,6065).
L'accuracy doit cependant être interprétée avec précaution en raison du fort déséquilibre des classes dans la zone de test. La classe Cropland représente à elle seule environ 77 % des pixels évalués. Une accuracy élevée peut donc être obtenue malgré des performances plus limitées sur les classes minoritaires.
Visualisation des résultats
Les performances quantitatives sont maintenant complétées par une analyse spatiale des prédictions. L'outil ci-dessous permet de visualiser les prédictions de LightGBM et XGBoost au format raster et de les comparer à la référence ESA World Cover. Il propose aussi d'afficher les rasters d'erreurs de classification pour les 2 modèles. La présence de pixels noirs (no data) sur les prédictions s'explique par les pixels exclus sur le cirtère de purity (pixels dont le label n'est pas considré comme assez fiable suite au rééchantillonnage à 20m).
Les deux modèles présentent une organisation spatiale globalement similaire, ce qui est cohérent avec leurs performances très proches sur la zone de test. Une tendance déjà observée dans l'analyse des erreurs apparaît également visuellement : les deux modèles semblent sur-prédire les surfaces de type Built-up.
Limites et perspectives d'amélioration
Les résultats présentés ici montrent que les données Sentinel-2 constituent des prédicteurs intéressants pour déduire l'occupation des sols à l'aide de modèles de Machine Learning relativement simples et peu coûteux. Les performances obtenues sur la zone de test sont encourageantes, mais plusieurs limites doivent néanmoins être gardées à l'esprit, autant sur le plan des données que sur celui de la méthodologie.
1. Une référence qui n'est pas totalement indépendante des prédicteurs
Les données de référence ESA WorldCover sont produites en partie à l'aide de données Sentinel-2. Même si la méthodologie de production de WorldCover est différente de celle suivie dans ce projet, cette dépendance constitue une limite méthodologique qui mérite d'être signalée : les variables utilisées comme prédicteurs et la donnée de référence ne sont pas complètement indépendantes. Les performances mesurées doivent donc être interprétées comme une évaluation par rapport à WorldCover, et non comme une mesure absolue de la capacité du modèle à retrouver une occupation du sol parfaitement indépendante.
2. Des choix de sampling et de qualité des labels à approfondir
Plusieurs paramètres ont été volontairement conservés constants afin de maintenir une méthodologie cohérente tout au long de l'étude. Le seuil de purity a notamment été fixé à 0,75, tandis que l'entraînement a été limité à un maximum de 10 000 pixels par classe. Ces choix permettent de contrôler la qualité des labels et le déséquilibre entre classes, mais ils constituent également des hyperparamètres méthodologiques qui pourraient être étudiés plus systématiquement.
Une analyse de sensibilité pourrait par exemple comparer plusieurs seuils de purity et plusieurs stratégies d'échantillonnage. L'objectif serait de mesurer le compromis entre quantité de données disponibles, fiabilité des labels et représentativité des classes.
3. Une forte difficulté sur les classes minoritaires
Les résultats montrent logiquement que les classes les moins représentées obtiennent des performances plus fragiles. C'est particulièrement visible pour les classes Bare / sparse vegetation et Herbaceous wetland, dont le nombre de pixels disponibles dans les zones étudiées est très faible.
Cette situation limite la fiabilité des métriques associées à ces classes et réduit la capacité du modèle à apprendre leurs caractéristiques spectrales. Malgré une sélection des AOI visant à conserver une diversité suffisante, une perspective naturelle serait donc d'intégrer davantage de zones géographiques présentant ces occupations du sol, notamment sur d'autres tuiles Sentinel-2 et WorldCover.
4. Une généralisation géographique encore à confirmer
Le protocole mis en place sépare les données géographiquement afin de limiter les phénomènes de fuite d'information liés à l'autocorrélation spatiale. Cette approche fournit une évaluation plus réaliste qu'une séparation aléatoire pixel par pixel, mais elle reste limitée à une seule zone d'étude et à une seule date d'acquisition Sentinel-2.
Les performances observées ne permettent donc pas encore de conclure que les modèles conserveraient le même niveau de performance sur d'autres régions, d'autres paysages ou d'autres conditions d'acquisition. Une validation sur plusieurs tuiles géographiques constituerait une étape importante pour évaluer la véritable capacité de généralisation spatiale du modèle.
5. Une information temporelle encore peu exploitée
L'étude repose ici sur une acquisition Sentinel-2 unique. Or certaines classes peuvent être difficiles à distinguer à partir d'une seule observation, notamment lorsque leurs signatures spectrales sont proches à une date donnée.
Une amélioration importante consisterait à exploiter une série temporelle de plusieurs acquisitions Sentinel-2. L'évolution saisonnière des indices spectraux et des bandes pourrait alors apporter une information complémentaire pour différencier, par exemple, certaines surfaces végétalisées ou agricoles dont la signature peut fortement varier entre autonmne, hiver, été ou printemps.
Perspectives
Plusieurs pistes permettraient ainsi de prolonger ce travail. Une première consisterait à réaliser un benchmark plus systématique des paramètres de préparation des données : seuil de purity, stratégie d'échantillonnage et pondération éventuelle des observations selon leur qualité.
Une seconde piste serait d'élargir le jeu de données à plusieurs régions et plusieurs dates, afin d'améliorer la représentativité des classes et de tester la robustesse géographique et temporelle des modèles. Enfin, l'utilisation de méthodes davantage orientées vers l'information spatiale ou temporelle, ainsi que de modèles plus avancés, pourrait être envisagée pour dépasser les limites observées sur les classes difficiles.
En résumé : les performances obtenues sont encourageantes, mais le principal enjeu pour une prochaine version du projet serait moins de chercher à gagner quelques points de performance sur une seule zone que de vérifier que ces performances restent robustes sur d'autres territoires, d'autres dates et des classes mieux représentées.